私が devcontainer を使う理由
私は開発のほとんどを devcontainer の中で行っています。 VS Code からコンテナに入り、その中で Claude Code を動かすやり方です。 README のデモ GIF を作ってもらった記事でも、録画はすべてコンテナの中で済ませました。
devcontainer を使い始めたのは、エージェントが出てくるよりずっと前です。 今は使う理由が変わりました。 エージェントがどこまで触れるかを、コンテナとボリュームの単位で決められるからです。 この記事では、その線をどう引いているかを書きます。 使い始めた経緯は別の記事にします。
サマリ
- エージェントが触れる範囲をコンテナの中に限ると、auto mode を安心して使える。 ブラウザのセッションや API キーから切り離せるうえ、実験的なツールをホストへ入れずに済む。
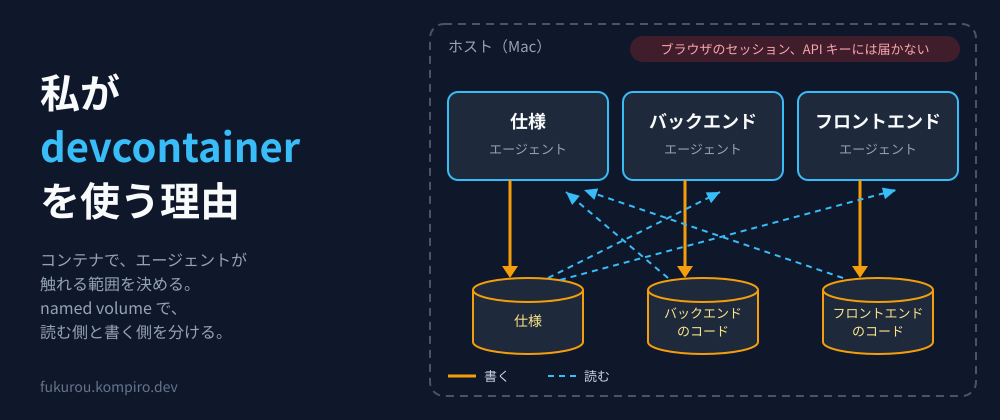
- named volume を使うと、環境どうしで読む側と書く側を分けられる。 個人で試している OpenSpec の構成では、仕様のコンテナが開発中のコードを読み、開発のコンテナが仕様を読む。
- devcontainer は万人には勧めない。 細かく調整できる分、覚えることが多い。ただ、devcontainer の設定の手直しはエージェントに頼める。
コンテナの中に閉じて守りたいもの
エージェントをコンテナの中に閉じる理由は 3 つあります。
1 つ目は、開発ツールを試しやすくするためです。 エージェントまわりのツールは出入りが激しく、実験的なものを試したくなる場面がよくあります。 そういうツールを、ホストの Mac には入れたくありません。 コンテナに入れておけば、合わなかったときはコンテナごと作り直せば済みます。
2 つ目は、秘匿情報に触らせないためです。 ホストのブラウザにはログイン中のセッションがいくつも残っていますし、各種の API キーもあります。 デモ GIF を作ったときに computer use ではなくコンテナの中の Playwright を選んだのも、同じ理由です。
3 つ目は、意図しないファイル削除です。 最近はあまり聞かなくなりましたが、エージェントがファイルを消してしまった話は何度か耳にしました。 コンテナの中のファイルだけが対象なら、消えても影響はそのコンテナにとどまります。
この 3 つがそろうと、auto mode を安心して使えます。 エージェントに確認を求められる回数が減っても、何に触れうるかは把握できているからです。
ただし、穴を 1 つだけ意図して開けています。
Claude Code の設定ディレクトリ(~/.claude)は、ホストから bind mount しています。
ホストで済ませた認証をコンテナで使うためと、プロジェクトごとのセッションを後から横断してふりかえるためです。
本番のイメージと開発の道具を分ける
コンテナの中に何を置くかにも線があります。
本番に出すイメージには、サービスの稼働に必要な最低限のファイルだけを入れたいです。 一方、開発の環境には、開発を助ける道具を自由に足せることが大事です。 そこで、本番の Dockerfile を土台にして、開発の道具は devcontainer の feature と dotfiles で足しています。 dotfiles の管理には yadm を、ツールのバージョン管理には mise を使っています。
dotfiles をコンテナに持ち込む理由の 1 つは、worktree の扱いです。 エージェントと開発していると worktree を多用します。 worktree を開き直したり切り替えたりする操作は、fzf のような手に馴染んだ道具でやりたいです。 作業場所がコンテナの中でも、自分の手で操作する環境はいつもと同じであってほしいからです。
named volume で環境どうしをつなぐ
コンテナを分けると、今度は環境どうしで共有したいものが出てきます。 私はそれを named volume でつないでいます。
compose を使うリポジトリでは、devcontainer.json の dockerComposeFile から、外部で作った network と volume を参照させています。
docker compose は、何もしなければ compose ファイルごとにプロジェクトとネットワークを作ります。
プロジェクト単位で up / down できるのは便利ですが、あるサービスだけを作り直したくてもできません。
そこで、network と volume をプロジェクトから切り離して管理しています。
いちばん素朴な共有は、認証情報です。 このブログのリポジトリでは、GitHub CLI と dev.to の認証情報を named volume に置いています。
"mounts": [
  "source=gh-config,target=/home/node/.config/gh,type=volume",
  "source=devto-config,target=/home/node/.config/devto,type=volume"
]
ボリュームはコンテナの外に残るので、コンテナを作り直しても認証し直す必要がありません。 それでいて、ホストの Mac とリポジトリのどちらにも残りません。
ソースコード自体も named volume に置いています。 Mac の bind mount は遅いからです。 ソースコードがボリュームにあると、別のコンテナからそのボリュームをマウントするだけで、同じコードを見せられます。
OpenSpec で仕様と開発をつなぐ
個人の開発で、OpenSpec を試しています。 OpenSpec は仕様を先に書いて開発を進めるためのツールで、変更の提案(change)を仕様のリポジトリに積んでいきます。
change を書くには、既存のソースコードを読む必要があります。 しかも、いま開発しているコードをそのまま読ませたい場面がありました。 そこで、開発のコンテナが使っているソースコードのボリュームを、仕様のコンテナにもマウントしています。
仕様のコンテナのエージェントには、そのソースコードを書き換えさせません。
仕様のコンテナの Claude Code の設定(settings.json)で、ソースコードのボリュームを additionalDirectories に加えていません。
仕様をまとめるエージェントは、コードを読むだけです。
逆向きのマウントもあります。 開発のコンテナには、仕様のボリュームをマウントしています。 仕様の進み具合を開発側から参照するためです。 これで、バックエンドとフロントエンドをそれぞれのコンテナで独立して開発しながら、同じ仕様を見られます。
| コンテナ | マウントするもの | エージェントが書くもの |
|---|---|---|
| 仕様 | 仕様のボリューム、開発中のソースコードのボリューム | 仕様だけ |
| バックエンドの開発 | バックエンドのソースコード、仕様のボリューム | バックエンドのコード |
| フロントエンドの開発 | フロントエンドのソースコード、仕様のボリューム | フロントエンドのコード |
コンテナで「エージェントが触れる範囲」を決め、ボリュームで「環境どうしでどちらが読み、どちらが書くか」を決めています。 読む向きと書く向きをコンテナごとに分けておくと、複数のエージェントを並べても、互いの作業場を荒らさずに済みます。
つまずくところ
devcontainer にも不満はあります。
devcontainer.json を書き換えると、コンテナの Rebuild が要ります。 設定を少し直すたびに作り直しを待つことになるので、書き換えるときは注意しています。 ディスクの消費は、私は気になっていません。
エディタも選びます。 Orca のような、AI エージェント向けの新しい IDE は devcontainer と組み合わせにくいです。 とはいえ、VS Code の Claude Code 拡張も早いペースで良くなっていると感じています。
万人に勧められるかというと、勧めません。 細かく調整できる分、大雑把には扱いにくく、初心者には覚えることが多いからです。
ただ、devcontainer の設定の手直しは、Claude Code や Codex に頼むとうまく直してくれます。 開発環境をコードにして再現できるようにしたい人には、勧めます。
まとめ
私が devcontainer を使い続けているのは、エージェントに任せる範囲を、コンテナとボリュームで決められるからです。 コンテナの中に閉じれば、秘匿情報と実験的なツールをホストから切り離したまま、auto mode で任せられます。 named volume でつなげば、環境どうしで読む側と書く側を分けたまま、同じコードや仕様を共有できます。
OpenSpec の構成はまだ試している途中です。 仕様と開発のコンテナを分けたことで、change の書き方や進め方がどう変わるかを、しばらく見ていきます。
感想や質問は、英語版を載せている dev.to のコメント欄でも受け付けています。