知らないリポジトリを地図にする:karasu の reverse-architecture スキルを公開しました
初めて触るリポジトリの全体像をつかむのは、いつも骨が折れます。 どんなサービスがあり、どのデータストアに何を書き、機能同士がどう依存しているのか。 README とディレクトリ構成から当たりを付け、ルーティングとスキーマを行き来しながら、頭の中に図を組み立てることになります。
この作業をエージェントに任せるスキル reverse-architecture を、Claude Code のプラグインとして公開しました。 スキルがリポジトリを読んでアーキテクチャをモデルに起こし、私が開発しているアーキテクチャ図ツール karasu がそれを描画します。
サマリ
- reverse-architecture は、リポジトリを karasu の
.krsに起こすスキルである。 頼めば、サービスからテーブルまでを 1 つの図にまとめる。 - OSS の Web 解析ツール umami で試すと、10 ドメイン、135 ユースケースのモデルができた。 調査担当のサブエージェントは合計約 96 万トークンを使い、統合までは約 10 分だった。
- 生成物はレビューして育てる地図であり、正解の図ではない。 判断に迷った境界は印付きで残り、図の読みやすさにはまだ改善の余地がある。使ってみて気になった点は、karasu に Issue で教えてほしい。
reverse-architecture と karasu の役割
karasu は、システムの論理構造、物理構造、組織構造をテキストの言語(.krs)で書き、図として描画するツールです。
一度にすべてを 1 枚に詰め込まず、システムからサービス、ドメイン、ユースケースへと段階的に降りていけることが特徴です。
文法や設計の考え方は紹介記事にまとめています。
reverse-architecture は、この .krs を既存のリポジトリから起こすスキルです。
役割は分かれていて、スキル(を実行するエージェント)がリポジトリを読んでモデルを書き、karasu の CLI がモデルを検証して描画します。
docker-compose の定義や DB スキーマがあれば、CLI が機械的に変換します。
そのため、エージェントがインフラ構成を推測で書かずに済みます。
使い方
Claude Code で次のように入れます。 スキルは karasu の CLI を呼び出すので、CLI も入れておきます。
npm i -g karasu
/plugin marketplace add kompiro/karasu
/plugin install karasu@karasu
あとは、調べたいリポジトリで Claude Code を開き、「このリポジトリを .krs に」や「アーキテクチャをリバースして」と頼むだけです。
エージェントはまずリポジトリ全体を偵察し、ドメインの分け方を提案します。
ドメインごとに調査担当のサブエージェントを立てるので、規模が大きいリポジトリではドメイン数とおおよそのコストを示して、進めてよいかを確認してきます。
了承すると調査と統合が進み、最後に index.krs が残ります。
いま対応しているエージェントは Claude Code だけです。
また、このプラグインは自動では更新されないので、新しいリリースは /plugin メニューから更新してください。
umami を地図にした結果
例として、OSS の Web 解析ツール umami(3.4.0、ソース約 1,300 ファイル)を地図にしました。 最上位の図はこうなります。
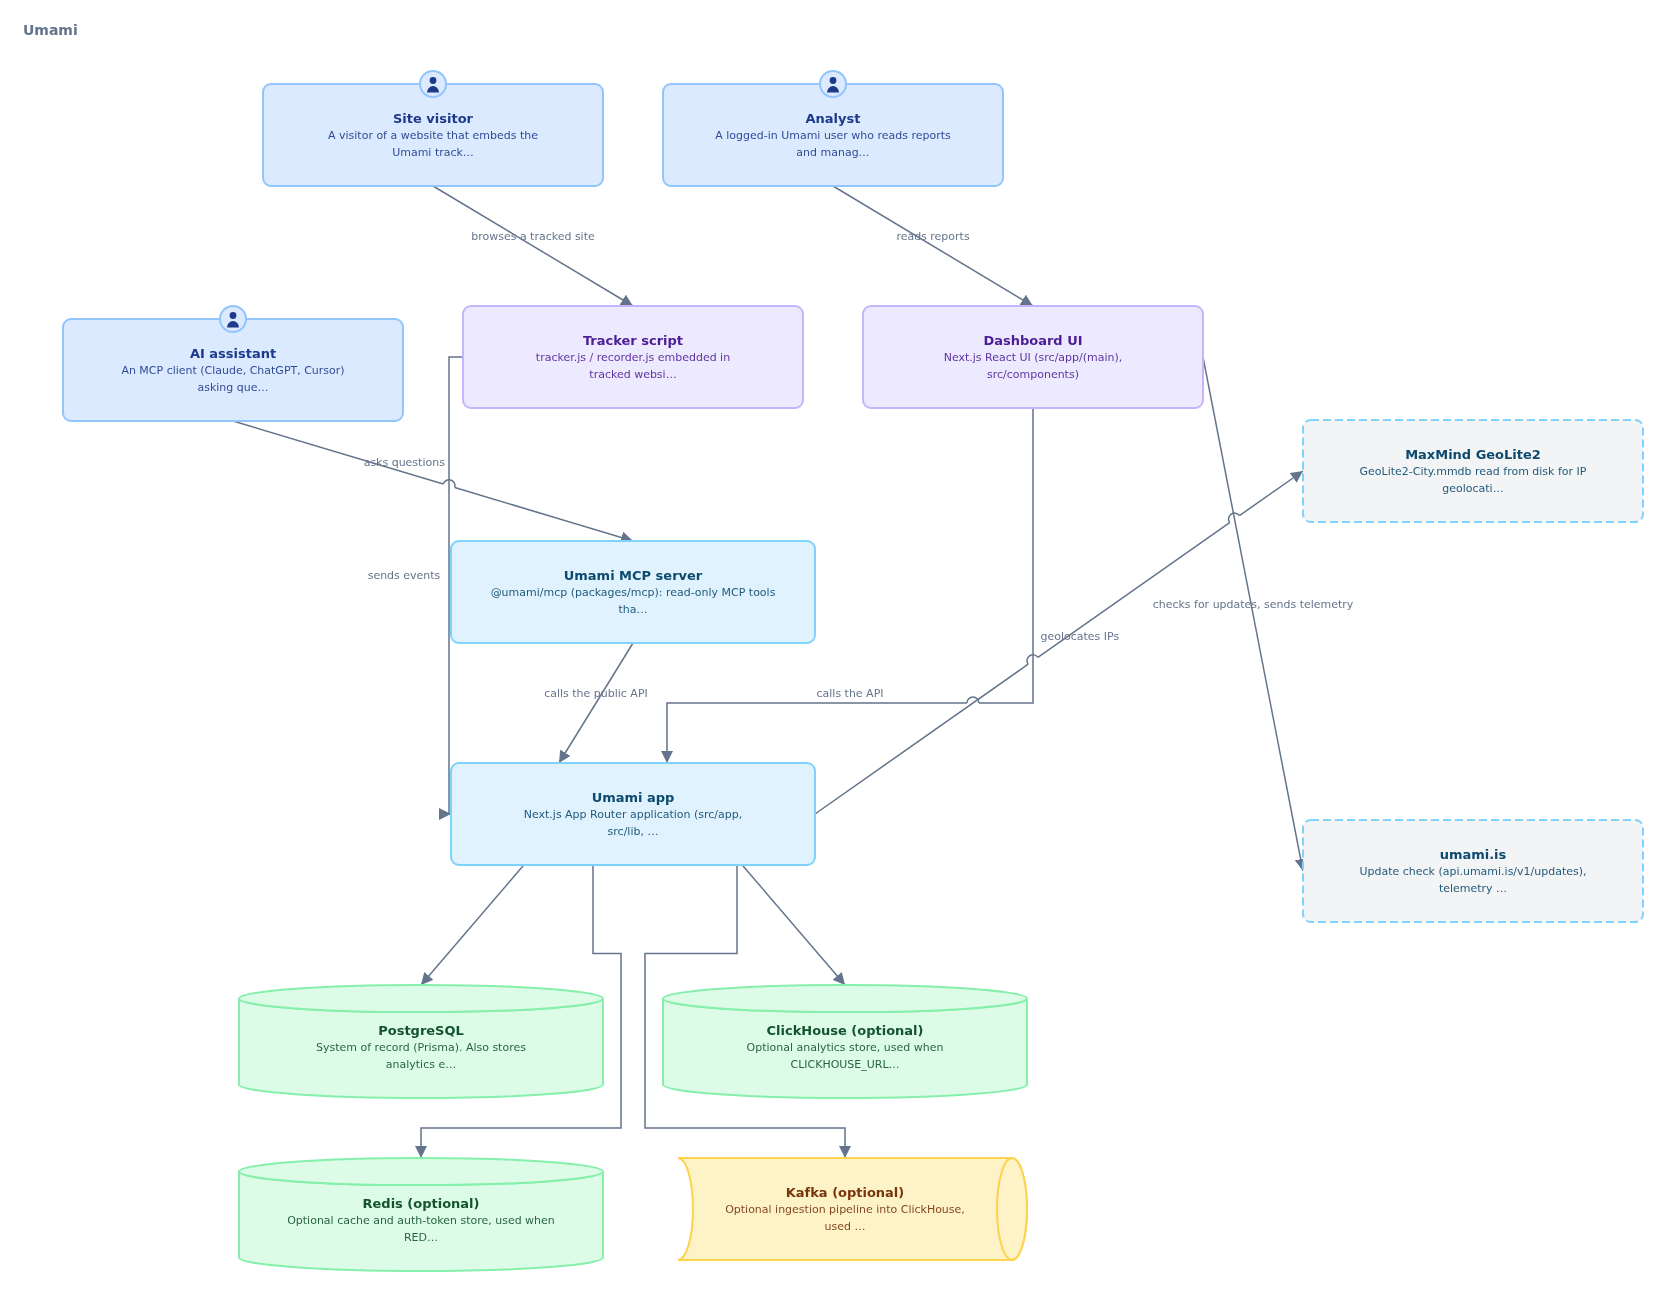
Next.js のアプリ 1 つが、トラッキング用のエンドポイント、API、ダッシュボードをまとめて提供しています。 データストアは PostgreSQL が必須で、ClickHouse、Redis、Kafka は設定したときだけ使われることも読み取れます。 この 1 枚の下に、次のモデルが入っています。
- ドメイン:トラッキング、分析、セッション録画、サイトとリンクとピクセル、ボード、共有、チーム、認証、管理、MCP ツールの 10 個
- ユースケース:135 個。それぞれが触る PostgreSQL や ClickHouse のテーブル、Redis のキー、Kafka のトピックを、読み書きの区別付きで持つ
- エンティティ:26 個。PostgreSQL の 26 テーブルはすべていずれかのエンティティに対応付いている
ドメインの中まで降りると図は細かくなるので、画像ではなく gallery で見てもらうのが確実です。 生成したモデルを karasu gallery に置きました。 Umami app からドメイン同士の依存へ、さらにドメインからユースケースとテーブルへと、図をたどって降りられます。 PostgreSQL などのデータベースにも降りられ、テーブル同士の関係を簡易的な ER 図として確認できます。 ユースケースの説明には、エージェントがコードから読み取った挙動(どの条件でどのテーブルに書くか、など)が書かれています。
かかったコストは次のとおりです。 調査を担当したサブエージェントは 10 体で、消費は 1 体あたり約 7 万から 15 万トークン、合計約 96 万トークンでした。 5 体ずつ 2 回に分けて走らせ、調査を始めてから統合が終わるまでは約 10 分です。 偵察と統合はメインのセッションで行ったので、その分はこの数字に含まれていません。
使うときに気をつけること
生成物は、レビューして育てる地図として扱ってください。
エージェントがドメインの境界を決めきれなかった箇所には @draft の印が付きます。
今回の umami では、「セッション録画をトラッキングから独立させるか」と「リンクとピクセルをサイトと同じドメインに置くか」の 2 か所に印が付き、どちらも調査の段階でコードを根拠に決着しました。
決着の理由はモデルの説明に残るので、人間が読んで違和感があれば直せます。
コストはドメインの数とリポジトリの大きさに比例します。 小さいリポジトリなら数十万トークンで済みますが、大きいリポジトリでは 1 ドメインあたり 10 万トークン以上を見込んでおくのが無難です。 ドメイン数の確認が来たら、その数字で判断してください。
リポジトリにインフラ構成の材料がない場合は、事前の準備を要することがあります。 umami は OpenAPI の仕様書をビルド時に生成していてリポジトリには含めていないので、依存を入れて生成してから渡しました。 DB スキーマも Prisma の定義から SQL に変換しています。 こうした材料がなくてもモデルは作れます。 ただしその場合、ユースケースやテーブルの洗い出しは、エージェントがソースを読む作業だけに頼ることになります。
図の読みやすさにも、まだ改善の余地があります。
今回の umami では、ドメイン同士をつなぐ矢印のラベルに、エージェントが依存の根拠を長々と書いたため、ドメイン間の図が文字で埋まりました。
これは Issue として起票し、ラベルは短くして根拠は説明に移すようスキルを直す予定です。
また、npm から入れた karasu では、ローカルのプレビューサーバー(karasu serve)がまだ動きません(Issue)。
それまでは karasu render index.krs -o arch.svg で SVG に書き出して見てください。
まとめ
reverse-architecture は、初めて触るリポジトリの全体像を、karasu の図として手元に起こすためのスキルです。 umami では、約 10 分の調査で、サービスからテーブルまでを 1 つのモデルにまとめられました。 完成した図というより、レビューの出発点になる地図です。
図の読みにくさや、モデルでうまく表せなかった構造に気づいたら、karasu の Issue で教えてください。 今回の 2 件も、実際に umami を地図にしてみて見つかったものです。
なお、自分のシステムを会話しながら .krs に書き起こし、育てていくためのスキルも準備しています。
こちらは公開したら改めて紹介します。